




Proxmox Backup Server lleno: cómo liberar espacio con Prune y Garbage Collection
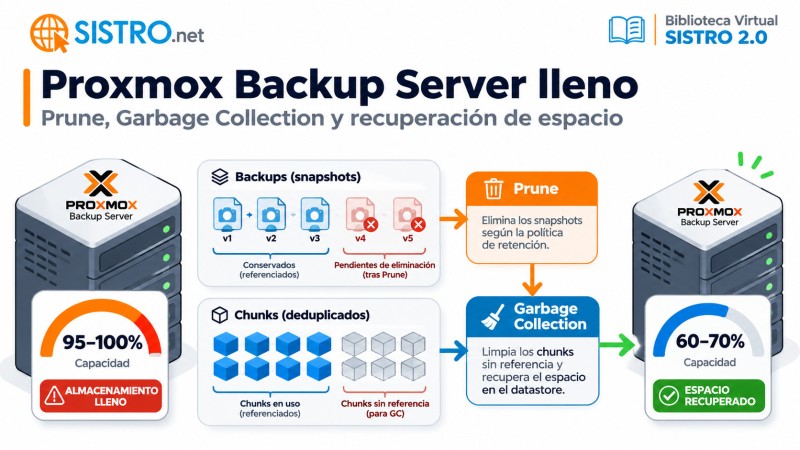
Tu servidor Proxmox Backup Server está casi lleno. Decides eliminar algunos respaldos antiguos, ejecutas Prune y confirmas que las copias desaparecieron de la lista. Sin embargo, el almacenamiento continúa al 95 % o incluso al 100 % de capacidad.
¿Por qué no se libera espacio si los respaldos ya fueron eliminados?
La respuesta está relacionada con la arquitectura de almacenamiento de Proxmox Backup Server (PBS), particularmente con la deduplicación, los chunks compartidos y el funcionamiento de Prune y Garbage Collection.
En algunas instalaciones, el problema puede agravarse hasta impedir la ejecución de nuevos respaldos e incluso provocar fallas en el propio proceso de Garbage Collection.
En esta guía de la Biblioteca Virtual SISTRO 2.0 explicamos cómo identificar las causas, interpretar los estados de mantenimiento, revisar los comandos CLI y recuperar una operación saludable sin borrar manualmente bloques que podrían ser necesarios para restaurar máquinas virtuales.
Alcance: Proxmox Backup Server 4.2, con metodología aplicable a versiones anteriores compatibles. Los ejemplos consideran datastores locales con almacenamiento Linux o ZFS. Las acciones de eliminación o recuperación requieren validación de la infraestructura y autorización administrativa.
1. ¿Por qué eliminar respaldos no libera espacio inmediatamente?
A diferencia de una carpeta convencional donde cada copia contiene sus propios archivos completos, Proxmox Backup Server utiliza una arquitectura basada en bloques deduplicados llamados chunks.
Cuando se genera un backup, PBS almacena bloques de información y crea índices que permiten reconstruir el contenido del respaldo.
Si varios backups utilizan bloques idénticos, esos chunks pueden reutilizarse.
Esto reduce la cantidad de almacenamiento necesaria, pero introduce una consideración importante:
Eliminar un snapshot no significa que todos los bloques que utilizaba puedan borrarse.
Otros respaldos pueden seguir dependiendo de esos mismos chunks.
Por ello, PBS separa las tareas de retención y limpieza física del almacenamiento.
2. Diferencia entre Prune y Garbage Collection
Esta es la distinción más importante para comprender el problema.
| Proceso | Qué realiza | Resultado esperado |
|---|---|---|
| Prune | Aplica políticas de retención y elimina metadatos de snapshots seleccionados | Desaparecen respaldos que ya no deben conservarse |
| Garbage Collection | Identifica chunks que ya no están referenciados y cumplen las condiciones de seguridad para eliminarlos | Puede recuperar espacio físico en el datastore |
| Verify | Comprueba la integridad de los datos de respaldo | Ayuda a detectar problemas de integridad; no es un proceso de limpieza |
Podemos resumir el ciclo así:
Backups existentes
        |
        v
Política de retención
        |
        v
Prune
Elimina snapshots obsoletos
        |
        v
Garbage Collection
Identifica chunks no utilizados
        |
        v
Limpieza segura de chunks elegibles
        |
        v
Espacio disponible recuperado
Una política de respaldo empresarial debe considerar ambos procesos.
Prune determina qué puntos de recuperación se conservan. Garbage Collection se encarga de recuperar los bloques que ya no necesitan esos puntos.
3. Cómo funcionan los chunks deduplicados
Consideremos un ejemplo ilustrativo.
Una empresa tiene tres respaldos diarios de una máquina virtual:
- Backup del lunes.
- Backup del martes.
- Backup del miércoles.
Los tres contienen una cantidad importante de datos que no han cambiado.
Gracias a la deduplicación, PBS puede mantener una sola copia física de determinados chunks compartidos.
Si eliminamos el backup del lunes, los bloques que también utilizan martes y miércoles deben permanecer almacenados.
Solamente los chunks que ya no estén referenciados por ningún respaldo válido podrán ser eliminados por Garbage Collection una vez que cumplan las condiciones correspondientes.
Por eso podemos eliminar muchos snapshots y recuperar mucho menos espacio del esperado.
La cantidad de snapshots eliminados no equivale directamente a la cantidad de gigabytes recuperables.
4. Primer diagnóstico: comprobar el datastore correcto
Antes de modificar la retención, necesitamos confirmar qué sistema de archivos está realmente lleno.
Desde la consola del servidor PBS ejecuta:
df -hT
lsblk -f
findmnt
Estos comandos muestran información sobre capacidad, sistemas de archivos, dispositivos y puntos de montaje.
Por ejemplo, el sistema operativo podría estar instalado en un SSD independiente y los respaldos almacenados en un conjunto de discos montado bajo:
/mnt/datastore/backup-empresaEn este caso debemos comprobar cuál de los dos sistemas está lleno.
Si el filesystem raíz está lleno, no necesariamente significa que el datastore de respaldos haya agotado su capacidad.
También conviene consultar los inodos disponibles:
df -iDependiendo del sistema de archivos, una falla de escritura puede estar relacionada con límites de espacio, metadatos, cuotas o inodos.
No debemos comenzar eliminando snapshots sin conocer qué almacenamiento presenta realmente la condición de error.
5. Identifica los datastores desde Proxmox Backup Server
Para consultar los datastores configurados:
proxmox-backup-manager datastore listEste comando permite identificar los nombres y las rutas configuradas.
También podemos utilizar la interfaz gráfica de PBS.
En la sección Datastore, selecciona el repositorio correspondiente y revisa:
- Summary: información general de utilización.
- Content: grupos y snapshots disponibles.
- Prune & GC: tareas de retención y limpieza.
- Verify Jobs: tareas de verificación de integridad.
- Sync Jobs: tareas de sincronización, cuando existan.
Antes de realizar cualquier cambio, registra la capacidad total, el espacio disponible y la fecha de la última ejecución de mantenimiento.
6. Segundo diagnóstico: comprobar las políticas Prune
Desde CLI puedes consultar las tareas programadas:
proxmox-backup-manager prune-job listPara consultar una tarea específica:
proxmox-backup-manager prune-job show ID_TAREASustituye ID_TAREA por el identificador real de la tarea.
Revisa:
- Datastore seleccionado.
- Namespace afectado, cuando corresponda.
- Frecuencia de ejecución.
- Retención de últimas copias.
- Retención diaria.
- Retención semanal.
- Retención mensual.
- Retención anual.
- Resultado de la última tarea.
Una tarea existente no garantiza que esté ejecutándose correctamente.
También debes comprobar si existen errores recientes o si la configuración conserva más snapshots de los que esperabas.
7. Cómo interpretar keep-last, keep-daily y keep-weekly
Proxmox Backup Server permite aplicar diferentes criterios de retención.
Por ejemplo:
- keep-last: conservar las últimas N copias.
- keep-hourly: conservar puntos representativos de las últimas horas correspondientes.
- keep-daily: conservar copias representativas de días.
- keep-weekly: conservar puntos semanales.
- keep-monthly: conservar puntos mensuales.
- keep-yearly: conservar puntos anuales.
Estas políticas no deben interpretarse como cantidades que necesariamente se suman sin considerar los intervalos ya cubiertos.
La lógica de retención conserva puntos representativos según los periodos y el orden de evaluación definidos por PBS.
Antes de modificar una política, utiliza el simulador oficial:
Proxmox Backup Server — Prune Simulator.
Así podrás observar el comportamiento esperado de diferentes criterios sin comenzar eliminando respaldos de producción.
8. Tercer diagnóstico: comprobar Garbage Collection
Después de verificar que Prune se ejecutó, debemos revisar la limpieza de chunks.
Para consultar el estado:
proxmox-backup-manager garbage-collection listPara un datastore específico:
proxmox-backup-manager garbage-collection status NOMBRE_DATASTOREEste es un comando de consulta. Sustituye NOMBRE_DATASTORE por el identificador real.
Revisa el resultado de la última ejecución y las estadísticas reportadas.
En la interfaz gráfica, selecciona el datastore y abre Prune & GC.
Si necesitas iniciar manualmente una tarea de limpieza, PBS dispone del comando:
proxmox-backup-manager garbage-collection start NOMBRE_DATASTOREAdvertencia: este último comando ejecuta una operación real de mantenimiento. Debe utilizarse solamente después de verificar que el datastore tiene condiciones adecuadas, que las tareas de respaldo están coordinadas y que conocemos el estado de la retención.
Garbage Collection puede consumir I/O significativo, especialmente en repositorios grandes.
9. Qué significan las fases Mark y Sweep
Garbage Collection utiliza dos fases principales.
Fase 1: Mark
PBS examina los índices de los snapshots conservados e identifica los chunks que todavía están referenciados.
Para registrar ese uso, actualiza la información de tiempo de acceso de los chunks correspondientes.
Fase 2: Sweep
El proceso recorre los chunks almacenados e identifica los que cumplen las condiciones para eliminarse.
La decisión considera el tiempo de acceso y un periodo de seguridad destinado a proteger bloques que todavía podrían estar involucrados en respaldos activos.
En configuraciones habituales, el umbral contempla 24 horas y 5 minutos, o un límite determinado por respaldos activos si corresponde.
Esta protección ayuda a evitar que una limpieza elimine chunks todavía necesarios para operaciones en curso.
Por eso la recuperación de espacio no siempre es inmediata después de eliminar snapshots.
10. ¿Por qué Garbage Collection muestra Pending removals?
Durante una tarea GC pueden aparecer bloques pendientes de eliminación.
El concepto Pending removals identifica chunks que todavía no se eliminan debido al periodo de seguridad.
En una situación típica, el procedimiento puede ser:
- Prune elimina los snapshots que ya no deben conservarse.
- Garbage Collection identifica chunks que dejaron de estar referenciados.
- Algunos chunks quedan pendientes por el periodo de seguridad.
- Una ejecución posterior, cuando ya cumplen las condiciones, puede eliminarlos.
No significa que cualquier cantidad de datos pendiente vaya a desaparecer inmediatamente después de transcurridas 24 horas.
Es necesario considerar el tiempo de acceso, las tareas concurrentes y si los chunks siguen siendo utilizados por otros backups.
No manipules manualmente los tiempos de acceso de los archivos para intentar acelerar el proceso. El mecanismo existe para proteger la consistencia del repositorio.
11. Garbage Collection terminó correctamente, pero liberó 0 bytes
Este resultado puede ocurrir sin que exista una falla del software.
Entre las posibles explicaciones están:
- Los chunks siguen referenciados por snapshots conservados.
- Los bloques todavía se encuentran dentro del periodo de seguridad.
- Prune no eliminó los snapshots que se esperaban.
- Existen snapshots protegidos contra eliminación.
- El repositorio conserva copias en otros grupos o namespaces.
- La deduplicación hace que los snapshots eliminados compartan casi todos sus datos con copias posteriores.
- El almacenamiento subyacente conserva bloques por otros mecanismos, como snapshots ZFS.
Antes de repetir GC continuamente, identifica cuál de estas condiciones se presenta.
Una ejecución con cero bytes recuperados no demuestra por sí sola que el mantenimiento esté averiado.
12. ¿Qué ocurre cuando el datastore llega al 100 %?
Esta es una situación más delicada.
Si un datastore no tiene espacio disponible, los nuevos respaldos pueden fallar.
Además, algunas operaciones de mantenimiento necesitan actualizar metadatos del sistema de archivos.
En mayo de 2026 se documentó en el foro oficial de Proxmox un caso de PBS con almacenamiento ZFS completamente lleno, donde Garbage Collection fallaba con un mensaje relacionado con atime y ENOSPC.
Un error representativo es:
TASK ERROR:
atime safety check failed:
update atime failed for chunk/file
ENOSPC: No space left on device
Esto significa que el proceso no consiguió realizar una operación necesaria sobre los archivos de chunks porque el almacenamiento no disponía de los recursos requeridos.
No recomendamos desactivar las verificaciones de seguridad de GC ni borrar manualmente los chunks para recuperar espacio.
13. Qué hacer si Garbage Collection falla por ENOSPC
Cuando el repositorio ya está completamente lleno, la prioridad es preservar los respaldos existentes.
El diagnóstico debería seguir este orden:
- Confirmar qué filesystem o pool presenta la condición de capacidad agotada.
- Comprobar si el datastore está montado correctamente.
- Revisar la capacidad física, cuotas y límites aplicables.
- Comprobar si existen snapshots ZFS que mantienen bloques ocupados.
- Identificar si hay operaciones de backup, sync o mantenimiento activas.
- Revisar los registros de Prune y Garbage Collection.
- Evaluar opciones seguras para ampliar capacidad o recuperar espacio que no pertenezca al almacén de chunks.
- Restablecer las condiciones necesarias para ejecutar GC de forma controlada.
- Validar la integridad y restaurabilidad de los respaldos después de la recuperación.
La intervención concreta depende de si el repositorio utiliza ZFS, ext4, XFS, almacenamiento externo u otra arquitectura.
Si es necesario ampliar capacidad, debe seguirse un procedimiento específico del sistema de almacenamiento.
En situaciones críticas, conserva evidencia y solicita apoyo técnico antes de realizar cambios destructivos.
14. Comandos de diagnóstico para almacenamiento ZFS
Si PBS utiliza ZFS, puedes recopilar información adicional mediante:
zpool list
zpool status
zfs list
zfs list -t snapshot
Estos comandos permiten consultar pools, capacidad, estado y snapshots.
Los snapshots ZFS pueden mantener bloques físicos aunque los archivos activos ya se hayan eliminado.
Por tanto, el espacio liberado por PBS no siempre coincide con el espacio que posteriormente muestra el pool.
También deben revisarse cuotas, reservas y datasets según la arquitectura.
No elimines snapshots ZFS automáticamente. Algunos pueden ser necesarios para estrategias de recuperación o consistencia del almacenamiento.
Antes de modificar snapshots, verifica qué datasets utilizan y qué procesos dependen de ellos.
15. Error frecuente: borrar archivos dentro de .chunks
Una recomendación peligrosa que puede encontrarse en foros es eliminar archivos manualmente dentro del directorio oculto .chunks.
Este procedimiento puede dañar el repositorio.
Los índices de PBS pueden necesitar esos bloques para restaurar respaldos que todavía aparecen como válidos.
Si eliminas manualmente chunks referenciados, puedes provocar errores de integridad o hacer imposible una restauración.
Lo mismo ocurre con modificaciones arbitrarias de metadatos y timestamps utilizadas para intentar evitar el periodo de seguridad de GC.
La limpieza de chunks debe realizarse mediante los mecanismos documentados de Proxmox Backup Server.
16. Caso práctico ilustrativo: un datastore al 96 %
Consideremos una empresa con:
- Un clúster Proxmox VE de tres nodos.
- Un Proxmox Backup Server dedicado.
- Un datastore con capacidad útil de 8 TB.
- Respaldos diarios de máquinas virtuales.
- Retención diaria, semanal y mensual.
El administrador detecta que el datastore se encuentra al 96 %.
Decide revisar la política de retención y observa que existen más puntos de recuperación de los previstos.
Después de evaluar los requisitos del negocio y utilizar el simulador de Prune, aplica una política autorizada.
Los snapshots eliminados desaparecen del listado.
Sin embargo, la capacidad disponible apenas cambia.
El administrador consulta los registros y detecta que Garbage Collection no se ejecutó después del proceso de retención.
Programa la limpieza, revisa los bloques pendientes y valida posteriormente qué datos pueden ser eliminados de forma segura.
Finalmente confirma que los respaldos restantes pueden verificarse y que los servicios críticos mantienen puntos de recuperación adecuados.
Este escenario es ilustrativo, no una intervención real realizada por SISTRO.
17. Cómo diseñar una política de mantenimiento adecuada
El objetivo no es borrar tantos snapshots como sea posible.
La política de retención debe considerar:
- RPO: pérdida máxima de datos aceptable.
- RTO: tiempo objetivo de recuperación.
- Frecuencia de respaldos.
- Volumen de cambios de las máquinas virtuales.
- Requisitos legales de conservación.
- Capacidad del datastore.
- Tiempo necesario para ejecutar GC.
- Ventanas de mantenimiento y carga de almacenamiento.
- Existencia de copias secundarias.
- Pruebas periódicas de restauración.
La documentación oficial recomienda programar Garbage Collection regularmente y considera una frecuencia semanal como punto inicial razonable para muchas instalaciones.
Sin embargo, no existe una periodicidad universal. Debe ajustarse según el crecimiento y la capacidad del entorno.
18. Verify: por qué recuperar espacio no es suficiente
Una vez que PBS vuelve a disponer de capacidad, debemos comprobar que los puntos de recuperación restantes sean válidos.
Para ello existe la función Verify.
Las tareas de verificación permiten comprobar la integridad del contenido almacenado y detectar problemas en los respaldos.
No sustituyen una prueba de restauración real.
Una organización debería realizar periódicamente restauraciones de prueba de máquinas virtuales, archivos y aplicaciones críticas.
Estas pruebas permiten identificar problemas que no se descubren solamente verificando que un backup terminó con estado OK.
El respaldo existe para recuperar información, no simplemente para mostrar una ejecución exitosa.
19. Checklist de diagnóstico para administradores
- ☐ Versión y compilación de PBS.
- ☐ Nombre y ruta del datastore.
- ☐ Sistema de archivos utilizado.
- ☐ Capacidad total y disponible.
- ☐ Estado del montaje.
- ☐ Estado de los dispositivos físicos.
- ☐ Políticas Prune configuradas.
- ☐ Fecha de la última ejecución Prune.
- ☐ Snapshots protegidos.
- ☐ Grupos y namespaces existentes.
- ☐ Estado de Garbage Collection.
- ☐ Chunks pendientes de eliminación.
- ☐ Bytes recuperados por la última GC.
- ☐ Posibles errores ENOSPC.
- ☐ Capacidad y snapshots ZFS, si aplica.
- ☐ Tareas de respaldo concurrentes.
- ☐ Verificación de integridad.
- ☐ Pruebas de restauración.
- ☐ Alertas de capacidad configuradas.
- ☐ Plan documentado de crecimiento.
20. Matriz rápida de diagnóstico
| Síntoma | Qué revisar |
|---|---|
| Prune terminó, pero no cambió el espacio | Garbage Collection y chunks compartidos |
| GC reporta 0 bytes recuperados | Referencias activas, retención y periodo de seguridad |
| Pending removals elevado | Periodo de seguridad y ejecuciones posteriores |
| GC falla con ENOSPC | Capacidad real del filesystem y metadatos |
| El datastore está montado, pero no permite backups | Espacio, permisos, cuotas y estado del almacenamiento |
| ZFS muestra menos espacio del esperado | Snapshots, cuotas, reservas y uso del pool |
| Los backups antiguos no desaparecen | Reglas Prune, protecciones, namespaces y fechas |
| Existe capacidad, pero hay errores de integridad | Verify, hardware y almacenamiento subyacente |
21. Soporte empresarial Proxmox en SISTRO.NET
La administración de respaldos empresariales requiere supervisar tanto la ejecución de las tareas como la capacidad, los puntos de recuperación y la integridad de los repositorios.
En SISTRO podemos apoyar a las organizaciones con proyectos de virtualización y soporte administrado Proxmox VE, incluyendo evaluación de almacenamiento, integración con Proxmox Backup Server, políticas de retención y pruebas de recuperación según el alcance contratado.
- Soluciones Proxmox VE para empresas.
- Soporte administrado Proxmox VE.
- Soluciones de virtualización empresarial.
Antes de ampliar infraestructura o modificar respaldos críticos, recomendamos revisar el crecimiento real del repositorio, las políticas de retención y la estrategia de continuidad operativa.
22. Preguntas frecuentes
¿Por qué Proxmox Backup Server sigue lleno después de borrar backups?
Porque Prune o la eliminación de snapshots no borran inmediatamente los chunks almacenados. Garbage Collection debe identificar cuáles ya no están referenciados y pueden eliminarse.
¿Qué diferencia hay entre Prune y Garbage Collection?
Prune aplica retención y elimina metadatos de snapshots. Garbage Collection recupera chunks que ya no están siendo utilizados y cumplen las condiciones de eliminación.
¿Qué significa Pending removals?
Indica que existen chunks pendientes de eliminación, normalmente relacionados con el periodo de seguridad de Garbage Collection.
¿Por qué GC no libera ningún byte?
Puede ocurrir porque los chunks siguen referenciados, están dentro del periodo de seguridad o no existen bloques elegibles para eliminación.
¿Cuánto debo esperar después de Prune?
El mecanismo de GC utiliza un periodo de seguridad que normalmente contempla 24 horas y 5 minutos en relación con el tiempo de acceso de los chunks. No debe interpretarse como una garantía de que todos los datos se eliminarán exactamente después de ese tiempo.
¿Qué significa ENOSPC en PBS?
Significa que el sistema no dispone del espacio o recursos de almacenamiento necesarios para completar una operación. Puede afectar respaldos y tareas de mantenimiento.
¿Puedo borrar manualmente la carpeta .chunks?
No. Esos bloques pueden ser necesarios para respaldos válidos. Eliminarlos manualmente puede provocar corrupción o pérdida de capacidad de restauración.
¿Cada cuánto debería ejecutar Garbage Collection?
Depende del tamaño del repositorio, la frecuencia de respaldos y los cambios de datos. Proxmox recomienda utilizar tareas programadas y considera la ejecución semanal como un punto de partida razonable para muchas instalaciones.
¿Prune elimina snapshots protegidos?
Los snapshots marcados como protegidos no pueden eliminarse mediante Prune mientras se mantenga esa protección. Es importante revisar estas condiciones antes de modificar una política.
¿Garbage Collection garantiza que mis respaldos funcionen?
No. Garbage Collection administra chunks no utilizados. La integridad debe comprobarse mediante Verify y la capacidad real de recuperación mediante restauraciones de prueba.
23. Documentación técnica oficial
- Proxmox — Maintenance Tasks, Pruning and Garbage Collection.
- Proxmox — Backup Client, Pruning and Garbage Collection.
- Proxmox — Command Syntax Reference.
- Proxmox — Prune Simulator.
- Proxmox — Backup Server Graphical User Interface.
- Proxmox Forum — I ran out of space, mayo de 2026.
Conclusión: eliminar snapshots y recuperar almacenamiento son operaciones diferentes
Cuando Proxmox Backup Server se queda sin espacio, el objetivo no debe ser borrar archivos manualmente ni ejecutar comandos destructivos para conseguir unos gigabytes adicionales.
Debemos identificar qué datos siguen referenciados, comprobar las políticas de retención, entender el funcionamiento de Garbage Collection y evaluar la capacidad real del almacenamiento.
La secuencia recomendada es: capacidad del datastore → política Prune → estado de GC → chunks pendientes → sistema de archivos → validación de backups.
Una plataforma empresarial de respaldo no solamente necesita almacenar datos. Debe conservar puntos de recuperación confiables, monitorear su crecimiento y demostrar que puede restaurar los servicios cuando sea necesario.
Continúa consultando nuestra Biblioteca Virtual SISTRO 2.0 y conoce las soluciones Proxmox de SISTRO.NET.
Deja un Comentario