




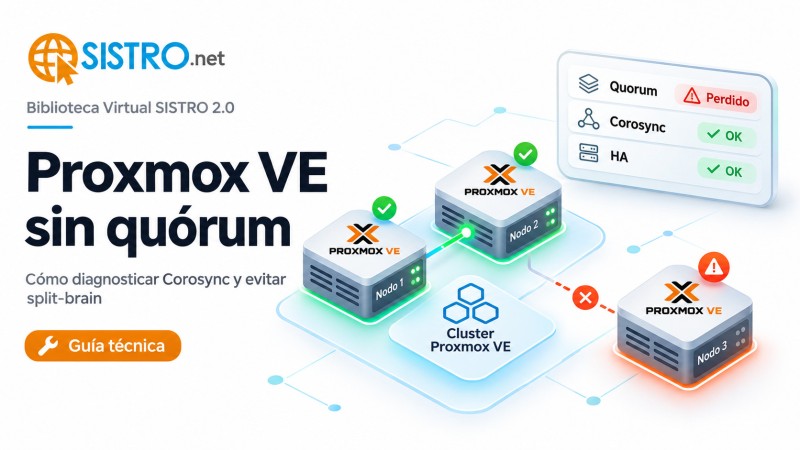
Proxmox VE sin quórum: guía de diagnóstico Corosync, HA y recuperación segura
¿Tu clúster Proxmox perdió el quórum o algunos nodos aparecen desconectados? Aprende a diagnosticar Corosync, revisar pvecm status, identificar problemas de red, entender el comportamiento de HA y evitar procedimientos que podrían provocar split-brain o interrumpir tus máquinas virtuales.
Un cluster Proxmox puede tener tres servidores encendidos, máquinas virtuales funcionando y almacenamiento disponible, pero aun así perder el quorum. Cuando esto sucede, aparecen errores de administración, algunos nodos pueden mostrarse desconectados y las funciones de alta disponibilidad pueden verse afectadas.
Este escenario genera una pregunta inmediata para cualquier administrador: ¿debo reiniciar Corosync, apagar los nodos o forzar el quorum para recuperar el cluster?
La respuesta correcta es: primero debemos identificar qué parte de la comunicación entre nodos está fallando. Una intervención incorrecta puede agravar el incidente y crear condiciones de split-brain.
En esta guía de Biblioteca Virtual SISTRO 2.0 explicamos cómo funciona el quorum, cómo consultar el estado de Corosync, qué revisar en la red, cómo interpretar el comportamiento del HA Manager y cómo construir una secuencia de recuperación segura.
Alcance: Proxmox VE 8.x y 9.x, con especial atención a clusters de tres nodos. Los comandos de consulta también son útiles en otras topologías. Los procedimientos que modifican la configuración del cluster requieren un análisis específico y una ventana de cambio autorizada.
1. ¿Qué significa perder el quorum en Proxmox?
Proxmox VE utiliza Corosync para coordinar la comunicación entre los miembros del cluster y proporcionar la información necesaria para su funcionamiento distribuido.
El quorum representa la cantidad de votos necesaria para que un grupo de nodos pueda tomar decisiones válidas dentro del cluster.
Imaginemos una instalación con tres servidores:
- PVE01: 1 voto.
- PVE02: 1 voto.
- PVE03: 1 voto.
En una configuración convencional con un voto por nodo, se necesitan al menos dos votos para disponer de mayoría.
| Nodos comunicados | Votos | ¿Existe quorum? |
|---|---|---|
| PVE01 + PVE02 + PVE03 | 3 de 3 | Sí |
| PVE01 + PVE02 | 2 de 3 | Sí |
| Solamente PVE01 | 1 de 3 | No |
| Partición de red 2 + 1 | 2 y 1 | Solo el grupo de dos conserva quorum |
Por eso un cluster de tres nodos permite tolerar la pérdida de un voto, siempre que los dos nodos restantes puedan seguir comunicándose correctamente.
Sin embargo, si los tres servidores pierden comunicación entre sí, no basta con que estén físicamente encendidos.
2. ¿Por qué Proxmox necesita proteger el quorum?
El objetivo principal es evitar decisiones contradictorias entre diferentes partes del cluster.
Supongamos que una falla de red divide la infraestructura:
- PVE01 y PVE02 pueden comunicarse entre sí.
- PVE03 queda aislado.
- Los tres servidores continúan encendidos.
Si ambos grupos pudieran modificar libremente el estado del cluster y administrar los mismos recursos sin coordinación, podrían producirse operaciones incompatibles.
En sistemas distribuidos, esta situación se conoce como split-brain.
En Proxmox, los mecanismos de quorum, bloqueo del sistema de configuración y fencing de alta disponibilidad buscan evitar que dos partes aisladas actúen simultáneamente sobre recursos críticos.
La pérdida de quorum es una protección, no necesariamente una falla del software.
3. Síntomas frecuentes de un cluster Proxmox sin quorum
Los síntomas dependen de qué componentes estén afectados y de si existen máquinas virtuales configuradas como recursos HA.
- Uno o varios nodos aparecen offline o con signos de advertencia.
- La interfaz web no permite determinadas operaciones.
- Algunas modificaciones de configuración no pueden guardarse.
- El sistema de configuración distribuida presenta restricciones de escritura.
- Las operaciones de migración o mantenimiento pueden fallar.
- El administrador observa eventos relacionados con Corosync, quorum o HA.
- En determinadas circunstancias, un nodo con recursos HA puede realizar self-fencing mediante watchdog.
Un punto importante: perder quorum no implica que todas las máquinas virtuales se apaguen inmediatamente. Algunas cargas no administradas por HA pueden continuar ejecutándose mientras el sistema limita operaciones del cluster.
El comportamiento de las cargas protegidas por HA es distinto y debe analizarse según el estado del watchdog y del gestor de alta disponibilidad.
4. Primer comando: pvecm status
El comando principal para comenzar el diagnóstico es:
pvecm statusEjecuta esta consulta en los nodos que todavía sean accesibles.
El resultado permite revisar información como:
- Nombre del cluster.
- Proveedor de quorum.
- Número de votos esperados.
- Votos actualmente disponibles.
- Quorum necesario.
- Estado Quorate.
- Miembros identificados por el cluster.
En un cluster convencional de tres nodos, un estado saludable debería indicar tres votos disponibles y quorum alcanzado.
Si el sistema muestra solamente un voto disponible frente a una mayoría requerida de dos, debemos determinar por qué los otros nodos no participan en la comunicación.
No modifiques los votos esperados como primera medida. Primero identifica si se trata de una caída real de servidores, una falla de switching, un problema de Corosync o una partición de red.
5. Segundo comando: revisa los miembros del cluster
Consulta la lista de nodos:
pvecm nodesCompara la información obtenida desde diferentes servidores.
Si PVE01 identifica únicamente a PVE02, mientras PVE03 no puede comunicarse con ninguno de ellos, probablemente exista una falla que afecta la comunicación del tercer nodo.
En cambio, si cada servidor identifica únicamente su propia membresía, podría existir una partición generalizada de la red del cluster.
Las dos situaciones requieren procedimientos distintos.
También conviene documentar la hora del incidente y cualquier cambio reciente en switches, VLAN, interfaces, bonding, rutas o configuración de Corosync.
6. Revisa los servicios Corosync y pve-cluster
Corosync y el servicio que mantiene el sistema de archivos de configuración del cluster son componentes esenciales.
Consulta su estado:
systemctl status corosync
systemctl status pve-cluster
También puedes obtener una comprobación resumida:
systemctl is-active corosync
systemctl is-active pve-cluster
Si un servicio no está activo, revisa los registros antes de reiniciarlo.
En un incidente de producción, reiniciar componentes del cluster sin entender el estado de los nodos puede complicar el diagnóstico y afectar recursos administrados por HA.
7. Consulta los registros con journalctl
La siguiente etapa consiste en recopilar evidencia.
journalctl -u corosync -b --no-pager -n 100Este comando muestra los últimos cien eventos del servicio Corosync durante el arranque actual.
Para revisar el servicio de configuración del cluster:
journalctl -u pve-cluster -b --no-pager -n 100Busca eventos relacionados con:
- Pérdida o recuperación de miembros.
- Cambios de quorum.
- Fallos de enlaces Kronosnet.
- Problemas de resolución de nombres.
- Errores de comunicación entre nodos.
- Eventos coincidentes con cambios de red.
Es importante comparar registros del mismo intervalo temporal en todos los nodos. Una única línea de error puede mostrar el síntoma, pero no necesariamente la causa.
8. Comprueba la red utilizada por Corosync
Una de las causas habituales de inestabilidad del quorum es una red de cluster con latencia, pérdida de paquetes o interrupciones de conectividad.
La documentación oficial de Proxmox establece que la comunicación del cluster necesita latencias de nivel LAN, inferiores a 5 milisegundos, para funcionar de forma fiable.
También recomienda evitar redes utilizadas intensivamente por otros servicios, especialmente cuando comparten tráfico con almacenamiento.
Empieza por identificar las interfaces:
ip -br addr
ip route
Después comprueba la conectividad hacia las direcciones utilizadas por Corosync.
Ejemplo ilustrativo:
ping -c 20 10.10.10.2
ping -c 20 10.10.10.3
Las direcciones 10.10.10.2 y 10.10.10.3 son ejemplos. Debes sustituirlas por las direcciones reales del cluster.
No basta con que exista respuesta a ICMP: revisa pérdida de paquetes, variabilidad de latencia y el comportamiento durante periodos de carga.
Un enlace aparentemente operativo puede sufrir interrupciones breves que afecten seriamente la comunicación de Corosync.
9. Revisa switches, VLAN, MTU y bonding
Si los nodos responden intermitentemente, revisa la infraestructura de red y no solamente Proxmox.
Comprueba:
- Estado físico de los puertos del switch.
- Errores y descartes en las interfaces.
- Configuración VLAN y tagged/untagged.
- Consistencia de MTU entre los extremos.
- Configuración de bonding y LACP.
- Rutas y subredes utilizadas por Corosync.
- Posibles bucles o cambios de topología.
- Eventos de mantenimiento o reinicio de switches.
Para consultar contadores de una interfaz:
ip -s link show dev eno1Sustituye eno1 por la interfaz correspondiente.
Un detalle importante: la documentación oficial de Proxmox advierte que determinados tiempos de recuperación de LACP pueden ser excesivos para entornos con HA si se utilizan temporizadores lentos.
Por ello recomienda revisar la configuración bond-lacp-rate fast cuando se utilizan enlaces LACP para Corosync, siempre con la configuración y validación correspondientes del switch.
10. ¿Debo utilizar 10 GbE para Corosync?
Corosync no necesita una cantidad enorme de ancho de banda. Su prioridad es la baja latencia, la confiabilidad y la estabilidad.
Una red de 1 GbE puede ser suficiente para la comunicación de Corosync si está correctamente diseñada y no presenta congestión.
Sin embargo, esto no significa que una infraestructura Proxmox con almacenamiento Ceph o migraciones de máquinas virtuales pueda operar eficientemente con cualquier red de 1 GbE.
Los requisitos de ancho de banda del almacenamiento distribuido son muy diferentes.
En un diseño empresarial podemos separar:
- Red de administración Proxmox.
- Comunicación Corosync.
- Red de máquinas virtuales.
- Tráfico de almacenamiento Ceph o SAN.
- Red de Live Migration.
- Red de respaldos.
Estas funciones pueden utilizar redes físicas independientes o mecanismos de segmentación y redundancia correctamente diseñados.
Una interfaz de 10 GbE no corrige por sí misma un problema de latencia, pérdida de paquetes o configuración de Corosync.
Si estás diseñando una plataforma hiperconvergente, consulta también nuestra guía sobre Proxmox y Ceph: cuándo conviene una infraestructura HCI y cuándo no.
11. Confirma la resolución de nombres y sincronización horaria
Además de la red física, revisa la configuración de identidad y los servicios básicos del sistema.
hostname -f
getent hosts $(hostname)
timedatectl status
Confirma que los nombres utilizados por el cluster resuelvan correctamente a las direcciones esperadas.
Si hay un servicio de sincronización horaria disponible, revisa también sus indicadores mediante la herramienta correspondiente.
Los nodos deben mantener una configuración coherente de nombres, direcciones y tiempo.
Una modificación accidental en /etc/hosts, DNS o en las direcciones de Corosync puede impedir que determinados miembros vuelvan a establecer comunicación.
12. ¿Qué ocurre con el sistema de archivos /etc/pve?
Proxmox utiliza pmxcfs, un sistema de archivos de configuración distribuida que mantiene información del cluster.
Cuando un nodo pierde quorum, determinadas operaciones de escritura sobre la configuración compartida quedan restringidas.
Esto evita que un nodo aislado modifique libremente información que podría entrar en conflicto con el grupo que conserva la mayoría.
Por eso un administrador puede observar que determinadas opciones de la interfaz web dejan de estar disponibles, mientras los procesos de algunas máquinas virtuales continúan activos.
Antes de intentar corregir permisos, archivos o servicios, confirma si la restricción es consecuencia de la pérdida de quorum.
13. Alta disponibilidad: por qué un nodo puede reiniciarse después de perder quorum
Este punto es especialmente importante en clusters empresariales.
El Proxmox HA Manager utiliza mecanismos de coordinación, bloqueo y watchdog para reducir el riesgo de que una misma carga sea ejecutada incorrectamente desde diferentes nodos.
Cuando un nodo tiene recursos HA activos y pierde las condiciones necesarias para mantener su estado de forma segura, el sistema puede activar mecanismos de self-fencing.
Dependiendo del escenario, esto puede provocar el reinicio del nodo para permitir una recuperación segura de las cargas en otra parte del cluster.
Consulta el estado general de HA:
ha-manager statusTambién puedes revisar los registros de sus componentes:
journalctl -u pve-ha-lrm -b --no-pager -n 100
journalctl -u pve-ha-crm -b --no-pager -n 100
Advertencia: nunca desactives mecanismos de fencing o watchdog únicamente para impedir un reinicio sin analizar los riesgos. Esos mecanismos forman parte de la protección frente a ejecuciones duplicadas y corrupción de datos.
14. Error peligroso: forzar el quorum sin investigar la causa
Una búsqueda frecuente entre administradores es cómo corregir el error de Proxmox sin quorum modificando temporalmente el número de votos esperados.
La documentación oficial describe procedimientos extraordinarios para modificar los votos esperados cuando es necesario reparar la configuración en un nodo sin quorum.
Sin embargo, no deben utilizarse como solución habitual para recuperar un cluster de producción.
Si otros nodos siguen encendidos y pueden estar operando como una partición separada, forzar decisiones locales puede introducir condiciones de split-brain.
Antes de cualquier recuperación extraordinaria debemos confirmar:
- Qué nodos siguen físicamente operativos.
- Qué grupo conserva quorum.
- Qué cargas se están ejecutando y dónde.
- Qué almacenamiento comparten los nodos.
- Si existe riesgo de acceso simultáneo a los mismos discos.
- Qué mecanismos HA y fencing están activos.
- Cuál es el procedimiento documentado para la arquitectura concreta.
La recuperación debe realizarse de forma coordinada por personal autorizado, no mediante comandos copiados sin comprobar el estado real del cluster.
15. Procedimiento de diagnóstico seguro paso a paso
Este orden de trabajo permite recopilar evidencia antes de modificar servicios.
Paso 1. Identifica todos los nodos
Confirma qué servidores están encendidos, cuáles son accesibles y dónde se ejecutan las máquinas virtuales.
Paso 2. Consulta el quorum
pvecm status
pvecm nodes
Registra votos, miembros y estado de mayoría desde cada nodo accesible.
Paso 3. Revisa servicios y eventos
systemctl status corosync
systemctl status pve-cluster
journalctl -u corosync -b --no-pager -n 100
Busca el primer evento relevante, no solamente el último mensaje de error.
Paso 4. Revisa conectividad y cambios recientes
Verifica interfaces, switching, rutas, MTU, bonding y direcciones de Corosync.
Paso 5. Identifica los recursos HA
ha-manager statusDetermina qué máquinas están protegidas y si existe actividad de fencing o recuperación.
Paso 6. Separa la causa de las consecuencias
Un error del sistema de configuración puede ser consecuencia de que Corosync perdió comunicación. Reparar primero el componente equivocado no resuelve necesariamente el origen.
Paso 7. Planifica la recuperación
Si identificas una causa en la red, corrige primero la comunicación con un procedimiento de cambio controlado. Evita reinicios masivos y modificaciones simultáneas.
Paso 8. Comprueba nuevamente el cluster
Cuando la comunicación se haya restablecido, verifica quorum, membresía, estado HA, accesibilidad del almacenamiento y funcionamiento real de las máquinas virtuales.
16. Caso práctico: tres nodos, dos activos y uno aislado
Consideremos un escenario ilustrativo:
- PVE01: servidor operativo.
- PVE02: servidor operativo.
- PVE03: servidor operativo, pero sin comunicación de Corosync.
- Un switch o enlace del tercer nodo presenta una falla.
En una configuración con un voto por nodo, PVE01 y PVE02 pueden conservar la mayoría de dos votos.
El nodo PVE03 queda fuera del grupo con quorum.
La acción correcta comienza determinando si la pérdida de comunicación se debe a un puerto, cable, interfaz, configuración VLAN o problema de red.
No debemos asumir que PVE03 necesita reinstalarse ni que debemos forzar votos en ese servidor para recuperar la administración.
Si existen recursos HA, también debemos comprobar su estado para evitar intervenciones que interfieran con los mecanismos automáticos de recuperación.
Este ejemplo representa una situación conceptual de laboratorio. No corresponde a una intervención real documentada por SISTRO.
17. Matriz rápida de síntomas y causas probables
| Síntoma | Primera revisión |
|---|---|
| Un nodo aparece offline | Red Corosync, interfaz y membresía |
| Los tres nodos están encendidos, pero no hay quorum | Particiones de red y configuración Corosync |
| /etc/pve no permite determinadas escrituras | Estado de quorum y pmxcfs |
| El HA Manager muestra fallas | Quorum, locks, CRM/LRM y watchdog |
| Falló después de cambiar switches | VLAN, LACP, MTU y rutas |
| Falló durante recuperación de almacenamiento | Congestión, latencia y separación de redes |
| Un nodo se reinicia inesperadamente | Eventos HA, watchdog y registros previos |
18. Checklist para administradores Proxmox
- ☐ Identificar la versión de Proxmox VE.
- ☐ Verificar los nodos encendidos y accesibles.
- ☐ Ejecutar pvecm status.
- ☐ Ejecutar pvecm nodes.
- ☐ Revisar estado del servicio Corosync.
- ☐ Revisar servicio pve-cluster.
- ☐ Consultar journalctl y correlacionar eventos.
- ☐ Verificar interfaces y rutas.
- ☐ Comprobar conectividad entre nodos.
- ☐ Revisar latencia y pérdida de paquetes.
- ☐ Verificar switching, VLAN, MTU y LACP.
- ☐ Comprobar resolución de nombres.
- ☐ Confirmar sincronización horaria.
- ☐ Revisar recursos HA activos.
- ☐ Identificar el estado de watchdog y fencing.
- ☐ Verificar acceso al almacenamiento.
- ☐ Evitar forzar quorum sin un plan de recuperación.
- ☐ Documentar la causa raíz y validar los servicios.
19. Cómo reducir el riesgo de volver a perder quorum
La prevención comienza desde el diseño de la infraestructura.
Para un ambiente empresarial resulta recomendable:
- Utilizar una red estable y de baja latencia para Corosync.
- Evaluar enlaces redundantes y caminos físicos independientes.
- Evitar que el tráfico de Ceph o las migraciones saturen la comunicación del cluster.
- Supervisar errores de interfaces y eventos de switching.
- Documentar todas las direcciones utilizadas por los nodos.
- Validar los cambios de red antes de aplicarlos en producción.
- Comprobar periódicamente las condiciones de quorum.
- Diseñar HA con capacidad N+1 y almacenamiento apropiado.
- Mantener respaldos verificables y un plan de recuperación.
También conviene recordar que quorum, HA, Live Migration y backup son funciones diferentes. Un cluster puede mantener quorum sin disponer de almacenamiento adecuado para recuperar determinada carga.
Para comprender el diseño original, consulta nuestra guía de cluster Proxmox de tres nodos: hardware, quorum y alta disponibilidad.
También puedes consultar Proxmox Live Migration y almacenamiento compartido para comprender las diferencias entre mantenimiento y recuperación por fallas.
20. Servicios Proxmox empresariales en SISTRO.NET
En SISTRO ofrecemos soluciones de virtualización empresarial orientadas al diseño, implementación, administración y continuidad operativa de plataformas Proxmox VE.
Si tu organización necesita implementar un cluster, revisar su arquitectura o diagnosticar una falla de quorum, puedes consultar:
- Soluciones Proxmox VE para empresas.
- Instalación y configuración Proxmox VE empresarial.
- Soporte administrado Proxmox VE.
Una infraestructura crítica requiere procedimientos operativos, monitoreo, configuración documentada y pruebas reales de recuperación.
21. Preguntas frecuentes
¿Qué significa No Quorum en Proxmox?
Significa que el nodo o conjunto de nodos no cuenta con los votos necesarios para participar con autoridad en determinadas decisiones del cluster.
¿Cómo puedo comprobar el quorum?
El comando principal es pvecm status. Complementa el diagnóstico con pvecm nodes para revisar los miembros identificados.
¿Se apagan las máquinas virtuales si Proxmox pierde quorum?
No necesariamente. Algunas máquinas virtuales pueden continuar ejecutándose. Sin embargo, los recursos protegidos por HA pueden tener comportamientos diferentes debido a los mecanismos de watchdog y fencing.
¿Puedo recuperar el quorum reiniciando Corosync?
Un reinicio podría formar parte de un procedimiento específico, pero no debe ser la primera acción. Antes conviene recopilar registros, comprobar la red y determinar qué nodos conservan quorum.
¿Necesito tres nodos para tener quorum?
Tres nodos con un voto cada uno constituyen una arquitectura habitual. También existen configuraciones distintas, como dos nodos con un QDevice externo, que requieren diseño y validación adecuados.
¿Corosync necesita una red de 10 GbE?
No necesariamente. Corosync requiere principalmente baja latencia, estabilidad y comunicación fiable. El ancho de banda necesario para Ceph, migraciones y almacenamiento debe analizarse por separado.
¿Qué es split-brain?
Es una condición en la que partes aisladas de un sistema distribuido pueden actuar de manera incompatible sobre recursos compartidos. Los mecanismos de quorum y fencing buscan prevenir ese riesgo.
¿Qué debo hacer antes de forzar quorum?
Confirmar el estado físico y lógico de todos los nodos, las cargas activas, el almacenamiento compartido, el estado HA y la existencia de otras particiones operativas. Las recuperaciones extraordinarias requieren procedimientos especializados.
22. Documentación técnica oficial
- Proxmox VE — Cluster Manager, quorum y Corosync.
- Proxmox VE — HA Manager, watchdog y fencing.
- Proxmox VE — documentación y guías oficiales por versión.
Conclusión: recuperar el cluster comienza por identificar la causa
Cuando Proxmox pierde quorum, el objetivo no debe ser hacer desaparecer el error lo antes posible mediante una modificación forzada.
El objetivo es determinar por qué los nodos dejaron de comunicarse y recuperar la operación sin comprometer la integridad del almacenamiento ni la seguridad de las cargas.
La secuencia recomendada es: quorum → membresía → Corosync → red → HA → recuperación controlada → validación de servicios.
Un cluster correctamente diseñado necesita mucho más que servidores potentes. Requiere networking confiable, mecanismos de coordinación, capacidad de recuperación y procedimientos administrativos.
Continúa aprendiendo en nuestra Biblioteca Virtual SISTRO 2.0 o conoce nuestras soluciones empresariales Proxmox VE.
Deja un Comentario